Era da un po’ che volevo capire seriamente come funzionasse un sistema RAG.
Non “capirlo” nel senso di leggere due articoli, imparare che RAG significa Retrieval-Augmented Generation e poi annuire con aria competente davanti allo schermo, perché quello bene o male riesce a chiunque. Volevo capire cosa succede quando si prende quella bella teoria, pulita e ordinata, e la si mette davanti a documenti veri, accumulati negli anni, scritti in formati diversi e spesso conservati senza alcuna particolare disciplina.
In altre parole, volevo vedere se un sistema RAG potesse davvero servirmi per costruire una sorta di archivio intelligente personale.
L’idea era abbastanza semplice: prendere una raccolta di documenti, elaborarli in locale e poi poterli interrogare in linguaggio naturale usando un modello di intelligenza artificiale, senza caricare nulla sul cloud e senza affidare i miei file a servizi esterni.
Volevo poter scrivere, per esempio, “dove si parla di questa persona?”, oppure “in quale documento viene citata questa attività?”, e lasciare che fosse il sistema a cercare l’informazione al posto mio.
Detto così sembra quasi una banalità.
Naturalmente non lo era.
Partire col piccolo
Per evitare di complicarmi la vita fin dal primo minuto, cosa che comunque sono riuscito a fare poco dopo, ho pensato di partire da un archivio relativamente piccolo composto da un centinaio circa di documenti. La maggior parte erano file Word DOCX, altri erano DOC e qualche PDF.
Una quantità gestibile, almeno sulla carta, ma già sufficiente per capire che prima ancora dell’intelligenza artificiale c’era un problema molto più elementare: leggere correttamente i documenti.
Per i file DOCX ho utilizzato Pandoc, un’applicazione a riga di comando molto diffusa in ambiente Linux che permette di convertire documenti da un formato all’altro. Nel mio caso l’ho utilizzato per trasformare i DOCX in Markdown, cioè file di testo strutturati e molto più semplici da elaborare automaticamente.
Per i vecchi file DOC ho invece utilizzato Antiword, un piccolo programma pensato appositamente per estrarre il testo dai documenti Word nel vecchio formato binario.
Per i PDF contenenti vero testo (non scansioni) bastava pdftotext, un’utilità a riga di comando che estrae il contenuto testuale dai PDF. Il nome, almeno quello, non richiede un master in informatica per capirne la funzione.
Fin qui sembrava tutto piuttosto lineare.
Poi sono arrivati i documenti veri.
Quelli con impaginazioni strane, intestazioni ripetute, con immagini, tabelle, formattazioni bizzarre, caratteri improbabili e altre amenità prodotte in anni di utilizzo di Word, scanner e software di ogni epoca.
Ed è stato lì che ho cominciato a capire che il problema non sarebbe stato tanto “fare funzionare l’AI”, quanto preparare decentemente quello che avrei dato in pasto all’AI.
Ma quindi cosa fa davvero un RAG?
Il concetto del RAG, in realtà, è molto meno misterioso di quanto il nome possa far pensare, perché il modello non “impara” davvero i documenti e non viene addestrato di nuovo ogni volta che gli diamo una cartella piena di file.
Succede qualcosa di molto più semplice.
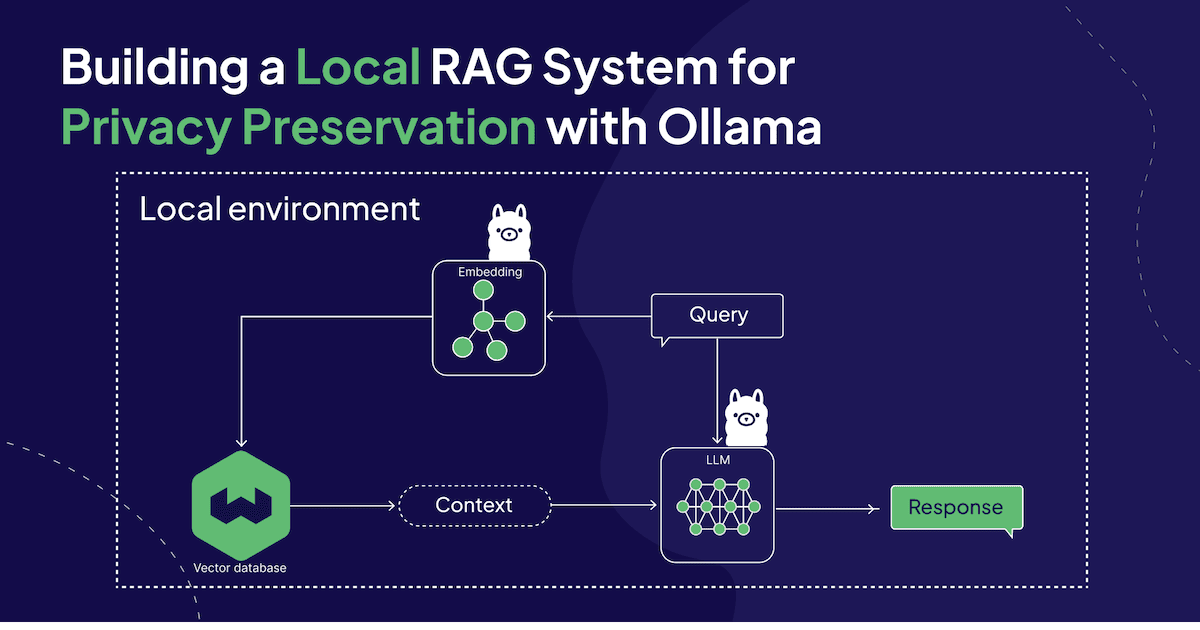
I documenti vengono prima trasformati in testo grezzo, poi spezzati in porzioni più piccole, chiamate chunk, cioè blocchi di testo abbastanza grandi da conservare un minimo di contesto ma non così enormi da diventare ingestibili. Ognuno di questi blocchi viene poi convertito in un embedding, vale a dire una rappresentazione numerica del significato del testo. In pratica non si memorizzano soltanto le parole, ma si cerca di rappresentare matematicamente quello che quel pezzo di testo vuole dire e, a questo punto, gli embedding vengono salvati in Chroma, un database vettoriale, cioè un archivio progettato per cercare elementi semanticamente simili invece di limitarsi a confrontare parole identiche.
Quando faccio una domanda, anche quella viene trasformata in embedding e il sistema va a cercare dentro Chroma i frammenti che risultano più vicini dal punto di vista del significato.
Solo a quel punto entra realmente in gioco il modello linguistico LLM.
Non gli viene consegnato tutto l’archivio, non gli si chiede di ricordare migliaia di documenti e non viene addestrato di nuovo. Gli vengono semplicemente messi davanti i pezzi che sembrano più pertinenti alla domanda, e lui prova a costruire una risposta usando quelle informazioni.
Detta così sembra quasi banale.
Ed è proprio questo il bello.
Il modello non deve conoscere i miei documenti in anticipo, deve soltanto ricevere quelli giusti nel momento giusto ed essere abbastanza bravo da capirli.
I primi collegamenti tra i vari pezzi
Per mettere insieme tutta questa pipeline ho utilizzato LangChain, una libreria Python pensata per costruire applicazioni basate su modelli linguistici. In pratica fornisce una serie di strumenti già pronti per caricare documenti, dividerli in blocchi, creare embedding, interrogare database vettoriali e passare i risultati della ricerca al modello.
Il modello veniva invece eseguito tramite Ollama, un programma che permette di scaricare e utilizzare modelli di intelligenza artificiale direttamente sul proprio computer, sfruttando CPU e GPU locali senza dover ricorrere necessariamente a servizi cloud.
Per questi esperimenti ho usato Gemma, che ormai nella mia macchina sta iniziando a ricoprire il ruolo del factotum di casa.
Qui vale la pena chiarire bene chi fa cosa, perché parlando genericamente di “RAG” si rischia di mettere tutto nello stesso calderone. Quando scrivo una domanda non è Gemma a trasformarla direttamente in qualcosa da cercare nel database: interviene prima un modello di embedding, che converte la domanda in un vettore numerico. Quel vettore viene poi passato a Chroma, che lo confronta con quelli già memorizzati e individua quelli più simili. Una volta trovate le corrispondenze migliori, Chroma recupera i blocchi di testo associati a quei vettori e li restituisce alla pipeline. A quel punto LangChain mette insieme la domanda e i contenuti recuperati, costruisce il prompt e lo passa a Gemma, che quindi riceve normale testo leggibile e non una sequenza di numeri.
Per evitare di dover interrogare tutto continuamente dal terminale ho poi realizzato una semplice interfaccia con Streamlit, un framework Python che permette di creare rapidamente piccole applicazioni web. In pratica aprivo una pagina nel browser, scrivevo una domanda in una casella e ricevevo la risposta direttamente lì.
L’interfaccia era semplice, ma dietro quella casella di testo avveniva tutta la trafila appena raccontata.
La prima volta che il sistema ha recuperato davvero il documento corretto la sensazione è stata abbastanza soddisfacente. Non perché avessi appena inventato qualcosa di nuovo, ovviamente, ma perché per la prima volta vedevo concretamente funzionare qualcosa che fino a quel momento avevo letto soltanto in teoria.
Quando la teoria comincia a sporcarsi le mani
A quel punto ho iniziato a fare domande su informazioni che sapevo essere presenti nei documenti, usando nomi, attività, riferimenti e situazioni reali.
In alcuni casi il sistema recuperava esattamente il documento che mi aspettavo e costruiva una risposta coerente. In altri casi, invece, una domanda formulata in un certo modo trovava il risultato giusto mentre la stessa domanda, scritta con parole leggermente diverse, portava a documenti meno pertinenti.
Ed è qui che si capisce una cosa importante: la ricerca semantica non è una magia infallibile.
Il sistema non cerca semplicemente una parola identica dentro un file, cerca qualcosa che abbia un significato simile. Questo permette di trovare informazioni anche quando il testo usa termini diversi rispetto alla domanda, ma significa anche che a volte possono saltare fuori pezzi che “sembrano” semanticamente vicini pur non essendo realmente utili.
La qualità dei risultati dipende quindi molto da come sono stati preparati i documenti, da come sono stati creati gli embedding e da come è stato spezzato il testo.
I famosi chunk, che sembravano un dettaglio
Uno dei primi parametri che ho dovuto iniziare a prendere sul serio è stata proprio la dimensione dei chunk.
All’inizio può sembrare un dettaglio tecnico di poca importanza, ma non lo è affatto.
Se il testo viene spezzato in blocchi troppo piccoli, si rischia di perdere il contesto. Una frase può contenere un riferimento a “lui” o “questa attività”, mentre il nome della persona o l’oggetto della discussione si trovano nel pezzo precedente.
Se invece i blocchi diventano troppo grandi, il sistema comincia a recuperare troppo testo e la ricerca perde precisione.
Per questo spesso si utilizza anche una certa sovrapposizione tra un chunk e quello successivo, in modo che una parte del testo venga ripetuta e non si rischi di spezzare un concetto proprio nel punto sbagliato. Sono quei dettagli che nei diagrammi teorici occupano una casellina minuscola ma poi li provi davvero e scopri che possono cambiare completamente la qualità delle risposte.
Un esempio semplice aiuta a capire cosa significa ricerca semantica. Immaginiamo queste due domande:
“Il sospettato era presente sulla scena?”
“Il sospettato era assente sulla scena?”
Le due frasi sono quasi identiche e differiscono per una sola parola, ma il significato cambia completamente. Un sistema basato soltanto sulla presenza delle parole vedrebbe due frasi praticamente uguali, mentre un buon modello di embedding dovrebbe rappresentarle in modo diverso proprio perché “presente” e “assente” cambiano il senso dell’intera domanda.
Lo stesso principio funziona anche al contrario: due frasi che usano parole diverse possono avere un significato molto simile. Per esempio:
“È stato acquisito il filmato della telecamera?”
“È stata effettuata una copia della registrazione video?”
Non condividono molte parole, ma parlano sostanzialmente della stessa operazione. È proprio questo il vantaggio degli embedding: cercare il significato, non soltanto una sequenza di termini identici.
Anche il concetto di chunk diventa più chiaro con un esempio. Immaginiamo che nel documento originale ci sia questa frase:
“Durante il sopralluogo è stata individuata una telecamera installata sopra l’ingresso principale. Il proprietario ha consegnato agli operatori una copia della registrazione relativa alla fascia oraria interessata, che è stata successivamente acquisita agli atti per essere analizzata.”
Se dividessimo il testo in blocchi senza alcuna sovrapposizione potremmo ottenere qualcosa del genere:
Chunk 1:
“Durante il sopralluogo è stata individuata una telecamera installata sopra l’ingresso principale. Il proprietario ha consegnato agli operatori”
Chunk 2:
“una copia della registrazione relativa alla fascia oraria interessata, che è stata successivamente acquisita agli atti per essere analizzata.”
Il problema è evidente: il secondo chunk parla di una “copia della registrazione”, ma ha perso parte del contesto che spiegava da dove provenisse e chi l’avesse consegnata.
Con una certa sovrapposizione, invece, i due blocchi potrebbero diventare:
Chunk 1:
“Durante il sopralluogo è stata individuata una telecamera installata sopra l’ingresso principale. Il proprietario ha consegnato agli operatori una copia della registrazione relativa alla fascia oraria interessata”
Chunk 2:
“Il proprietario ha consegnato agli operatori una copia della registrazione relativa alla fascia oraria interessata, che è stata successivamente acquisita agli atti per essere analizzata.”
In questo modo una parte della frase compare in entrambi i chunk e il secondo blocco conserva abbastanza contesto per essere comprensibile anche se viene recuperato da solo. È questo il motivo per cui nei sistemi RAG si usa spesso una certa sovrapposizione tra un chunk e il successivo: si sacrifica un po’ di spazio, ma si evita di tagliare un concetto esattamente nel punto peggiore possibile.
Poi, naturalmente, ho deciso di complicarmi la vita
Una volta verificato che il sistema funzionava sui quei documenti avrei potuto fermarmi lì, dichiarare vittoria e andare a fare qualcosa di più sensato.
Invece ho preso un secondo archivio.
Questa volta i file erano 1688.
E soprattutto erano molto più rappresentativi di quello che si trova veramente su un disco usato per anni: documenti Word, PDF, immagini, GIF, file HTML, database, vecchi formati, file video e una discreta quantità di roba della quale probabilmente avevo dimenticato perfino l’esistenza.
A quel punto il problema era cambiato completamente.
Non si trattava più semplicemente di costruire un RAG, ma di capire come trasformare quella montagna di materiale in qualcosa che il sistema potesse realmente utilizzare.
E qui è comparso un altro problema abbastanza grosso: le scansioni.
Un PDF non è sempre un vero PDF
Noi apriamo un PDF sullo schermo, vediamo una pagina con del testo e naturalmente pensiamo che il computer possa leggerlo.
Non è necessariamente così.
Molti PDF sono semplicemente una raccolta di immagini ottenute da uno scanner. Per noi sono perfettamente leggibili, ma per il computer non contengono praticamente testo.
In quei casi pdftotext non può fare miracoli.
Serve quindi l’OCR, Optical Character Recognition, cioè un sistema capace di analizzare un’immagine e tentare di riconoscere le lettere e le parole che contiene.
Il documento scansionato deve quindi prima essere trasformato in testo tramite OCR, poi il testo deve essere ripulito, spezzato nei soliti chunk, trasformato in embedding e infine inserito nel database vettoriale. Qui che le cose cominciano a diventare interessanti, perché ogni passaggio può introdurre errori. Se l’OCR interpreta male un nome, quel nome potrebbe diventare impossibile da trovare. Se sbaglia una data, potrei ritrovarmi con informazioni cronologicamente errate. Se un pezzo di testo viene spezzato male, il modello potrebbe ricevere soltanto metà del contesto necessario per capire cosa sta leggendo.
A quel punto è diventato abbastanza evidente che il modello linguistico era quasi l’ultimo dei miei problemi.
Garbage in, garbage out
Uno degli errori più facili da fare con questi sistemi è dare la colpa al modello ogni volta che arriva una risposta sbagliata. Se la risposta non torna si tende subito a pensare che il modello sia troppo piccolo, poco intelligente o non abbastanza sofisticato.
A volte può essere vero.
Molto spesso però il modello sta semplicemente lavorando con informazioni sbagliate o incomplete ovvero il sistema recupera il frammento sbagliato, il modello leggerà quello. Se l’OCR ha interpretato male il documento, il modello leggerà l’errore. Se il testo è stato estratto male, il modello non ha nessun modo magico per sapere cosa c’era scritto davvero.
La vecchia regola informatica “garbage in, garbage out” continua insomma a funzionare benissimo anche nell’epoca dell’intelligenza artificiale.
Puoi chiamarla AI, RAG, LLM o come preferisci.
Se gli dai spazzatura, otterrai spazzatura molto ben scritta.
RAG e fine tuning non sono la stessa cosa
Durante questi test mi è venuta spontaneamente un’altra idea: utilizzare lo stesso archivio per creare un dataset e provare successivamente un fine tuning con strumenti come Unsloth che dovrebbe (dicono) semplificare l’addestramento e l’adattamento di modelli linguistici riducendo le risorse necessarie.
A quel punto, però, bisogna distinguere bene le due cose.
Il RAG non modifica il modello.
Il modello resta esattamente quello che era prima e riceve semplicemente informazioni esterne quando servono.
Il fine tuning invece cambia davvero il comportamento del modello attraverso un processo di addestramento aggiuntivo.
Sono quindi due strumenti diversi e non necessariamente alternativi.
Da qui è nata l’idea di fare, prima o poi, un confronto usando lo stesso modello in tre situazioni diverse: completamente originale, accompagnato dal RAG e infine sottoposto a fine tuning utilizzando un dataset ricavato dallo stesso archivio.
Non tanto per stabilire un vincitore, ma per capire dove abbia senso utilizzare una tecnica e dove l’altra.
Perché addestrare nuovamente un modello, se magari basta semplicemente mettergli davanti il documento giusto?
La parte che mi interessa davvero: tutto resta in casa!
Fin dall’inizio volevo che tutto questo funzionasse completamente in locale.
I documenti restano sul computer, gli embedding vengono generati sulla mia macchina, il database vettoriale resta sul mio disco e il modello gira tramite Ollama sfruttando il mio hardware.
Per un archivio personale non è un dettaglio secondario.
Significa poter lavorare su documenti privati senza doverli inviare a qualche servizio esterno e senza dipendere da connessioni, abbonamenti o API.
Ed è proprio questo uno dei motivi per cui molti produttori di hardware stanno puntando su sistemi pensati per eseguire modelli di intelligenza artificiale direttamente in locale, all’interno delle aziende. Quando si lavora con dati sensibili o riservati, infatti, affidarsi a servizi esterni significa dover fare i conti anche con tutte le norme che disciplinano il trattamento dei dati da parte di soggetti terzi.
Non è quindi difficile capire perché macchine compatte ma abbastanza potenti da eseguire modelli localmente abbiano attirato così tanto interesse: i Mac mini, per esempio, sono diventati una scelta molto popolare proprio per questo tipo di utilizzo, mentre chi ha bisogno di più memoria e potenza può spingersi sui ben più costosi Mac Studio. In pratica, invece di mandare continuamente dati sul cloud, si porta la capacità di elaborazione direttamente in azienda.
Alla fine non stavo più costruendo soltanto un RAG
Quando avevo iniziato l’esperimento volevo semplicemente capire come funzionasse questa tecnologia.
Dopo qualche giorno mi sono accorto che stavo pensando a qualcosa di diverso. Non più una semplice chat alla quale dare in pasto dei documenti, ma una specie di motore di ricerca personale capace di lavorare sopra anni di archivi. Un sistema nel quale poter chiedere di trovare tutti i documenti che parlano di un determinato argomento, ricostruire una vicenda in ordine cronologico oppure individuare dove e in quale contesto compare una certa persona, senza dover ricordare il nome esatto del file o la cartella nella quale l’avevo archiviato anni prima.
E magari, insieme alla risposta, avere anche il riferimento preciso ai documenti utilizzati, in modo da poterli aprire e verificare direttamente.
A quel punto il RAG smette di essere semplicemente una parola di moda e comincia a diventare qualcosa di realmente utile.
Perché di chatbot ne abbiamo ormai abbastanza da poterli vendere a peso.
Quello che mi interessa molto di più è riuscire a usare l’intelligenza artificiale per ritrovare e capire meglio le informazioni che possiedo già, ma che sono disperse dentro decine di cartelle nidificate.
Il progetto è ancora in evoluzione e sicuramente ci sono molti aspetti da migliorare, soprattutto nella gestione dell’OCR, nella qualità dell’indicizzazione e nel recupero dei documenti più pertinenti.
Ma almeno una cosa ormai mi è chiara.
Il RAG non è un modo per rendere magicamente intelligente un modello.
È un modo per mettergli davanti, al momento giusto, le informazioni che gli servono davvero.
E già questo, fatto bene, può cambiare parecchio il modo in cui utilizziamo i nostri archivi.